



데이터는 정보화 시대의 인간 생활에 소중한 자산입니다. 데이터가 방대한 출처에서 유입되면서 최근 대부분의 조직은 데이터 통합과 거버넌스에 어려움을 겪고 있습니다. 따라서 각 기업에는 이 문제를 해결하고 비즈니스 성과를 높일 종합적인 솔루션이 필요합니다. 이 블로그에서는 이러한 과제를 수행하기 위한 일반적인 접근 방식을 소개합니다.
데이터 웨어하우스
먼저 데이터 웨어하우스의 정의와 주요 특성을 살펴보겠습니다.
정의
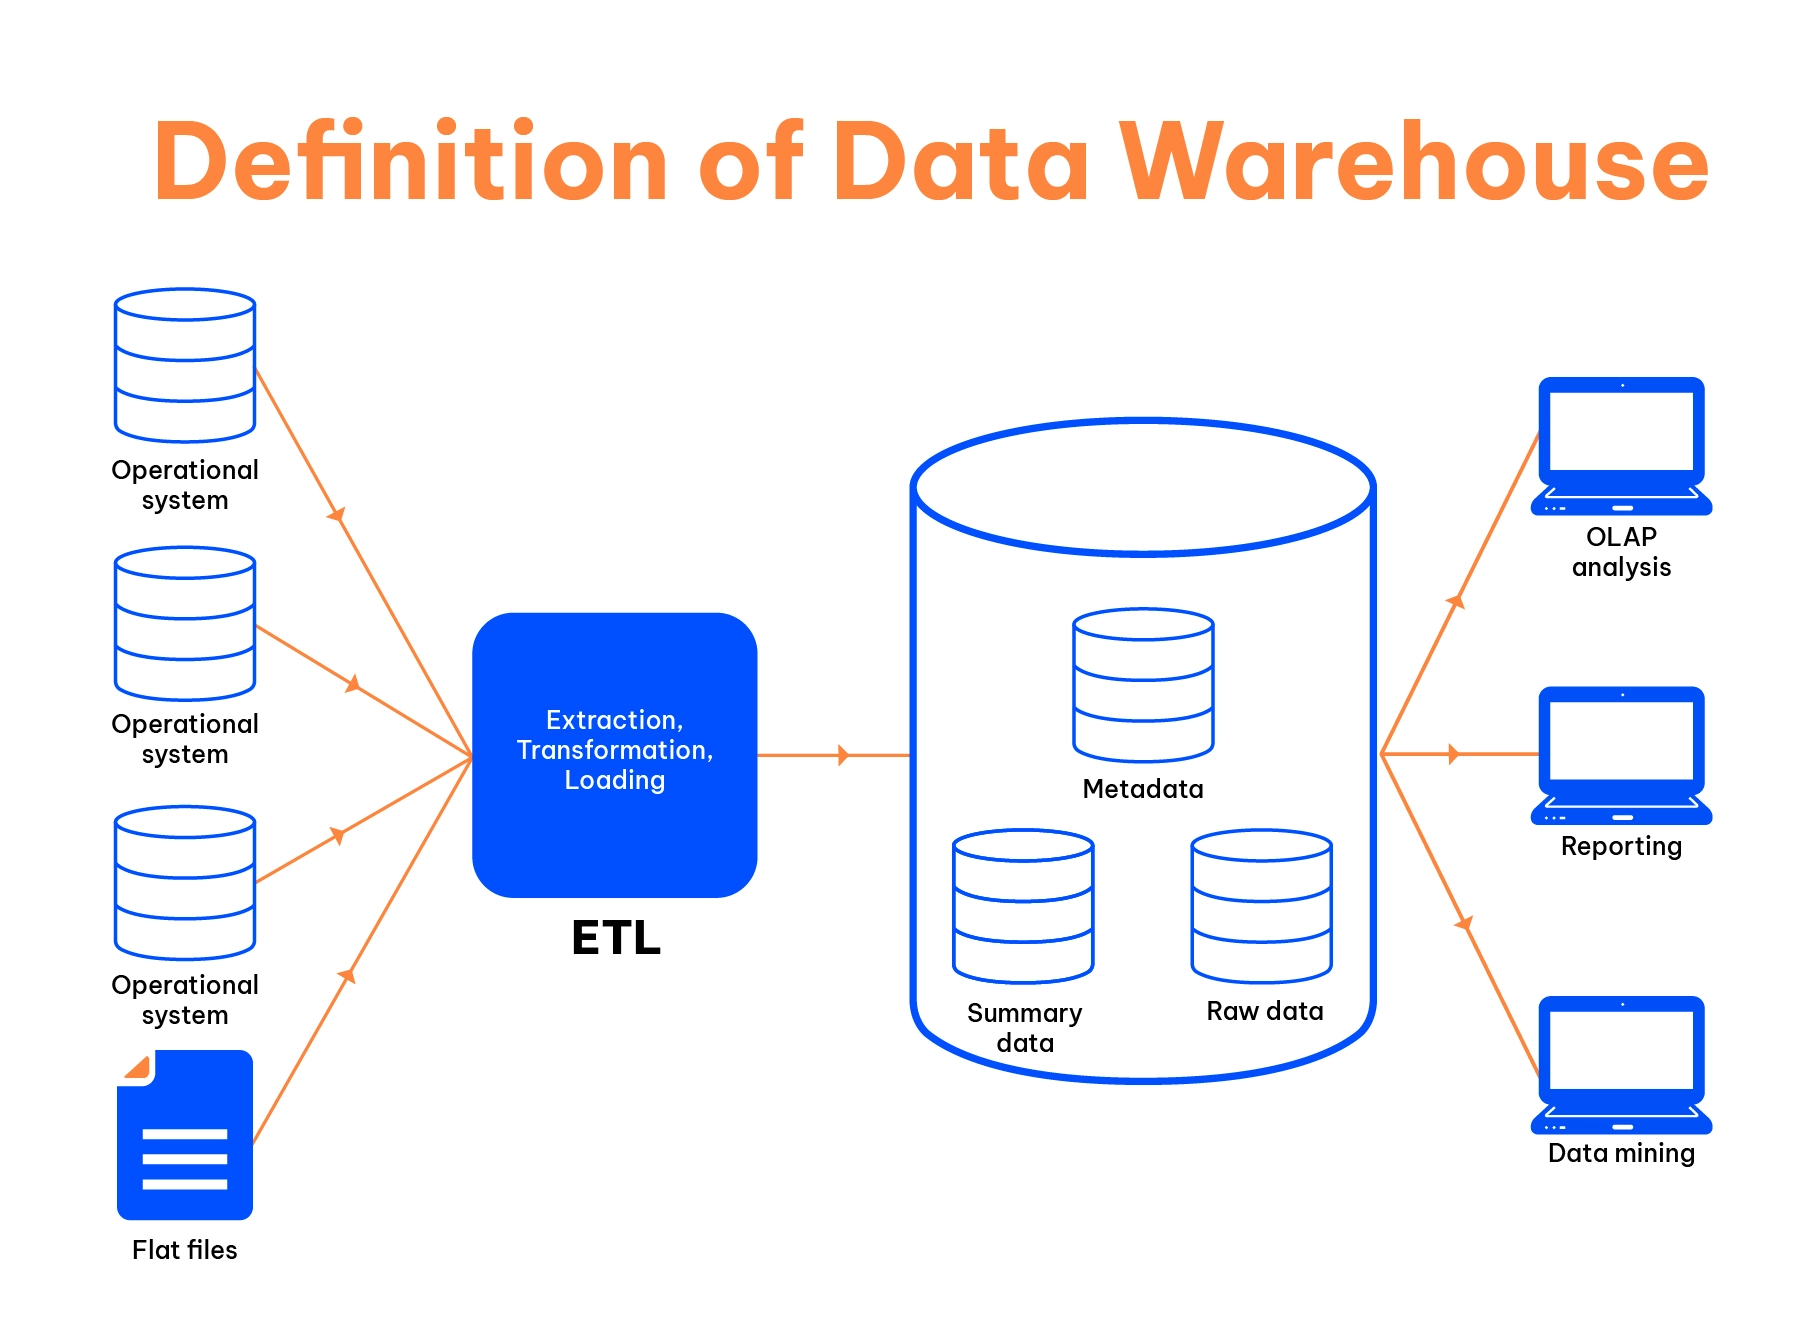
데이터 웨어하우스는 변환된 데이터를 저장하는 중앙 저장소입니다. 데이터 웨어하우스에 한 번 저장된 데이터는 변경할 수 없습니다. 정형, 반정형 또는 비정형 입력 데이터 등 다양한 유형의 데이터는 데이터 웨어하우스에 들어가기 전에 ETL 프로세스를 통해 변환됩니다. 데이터 웨어하우스의 주요 기능은 과거 데이터를 분석하고 쿼리를 실행하는 것입니다.
데이터 웨어하우스의 특성
데이터 웨어하우스는 의사결정을 지원하는 데이터 관리 시스템으로 간주됩니다. 다음과 같은 네 가지 고유한 특성이 있습니다.
주제 지향성
데이터 웨어하우징 프로세스는 조직의 기존 운영 업무보다는 영업, 유통 또는 마케팅과 같은 특정 주제를 다루도록 설계됩니다. 데이터를 모델링하고 관련이 없거나 중복된 정보를 제거하여 특정 주제에 관한 의사결정에 집중합니다.
통합성
데이터 웨어하우스를 구축하기 위해 메인프레임, 플랫 파일, 관계형 데이터베이스를 비롯한 수많은 출처의 데이터를 통합합니다. 이러한 데이터 웨어하우스 통합은 서로 다른 데이터베이스에서 가져온 모든 유사 데이터에 표준 형식을 적용하여 적절한 데이터 분석을 지원합니다. 핵심은 명명 규칙, 척도, 인코딩 구조 등의 신뢰성을 보장하는 것입니다.
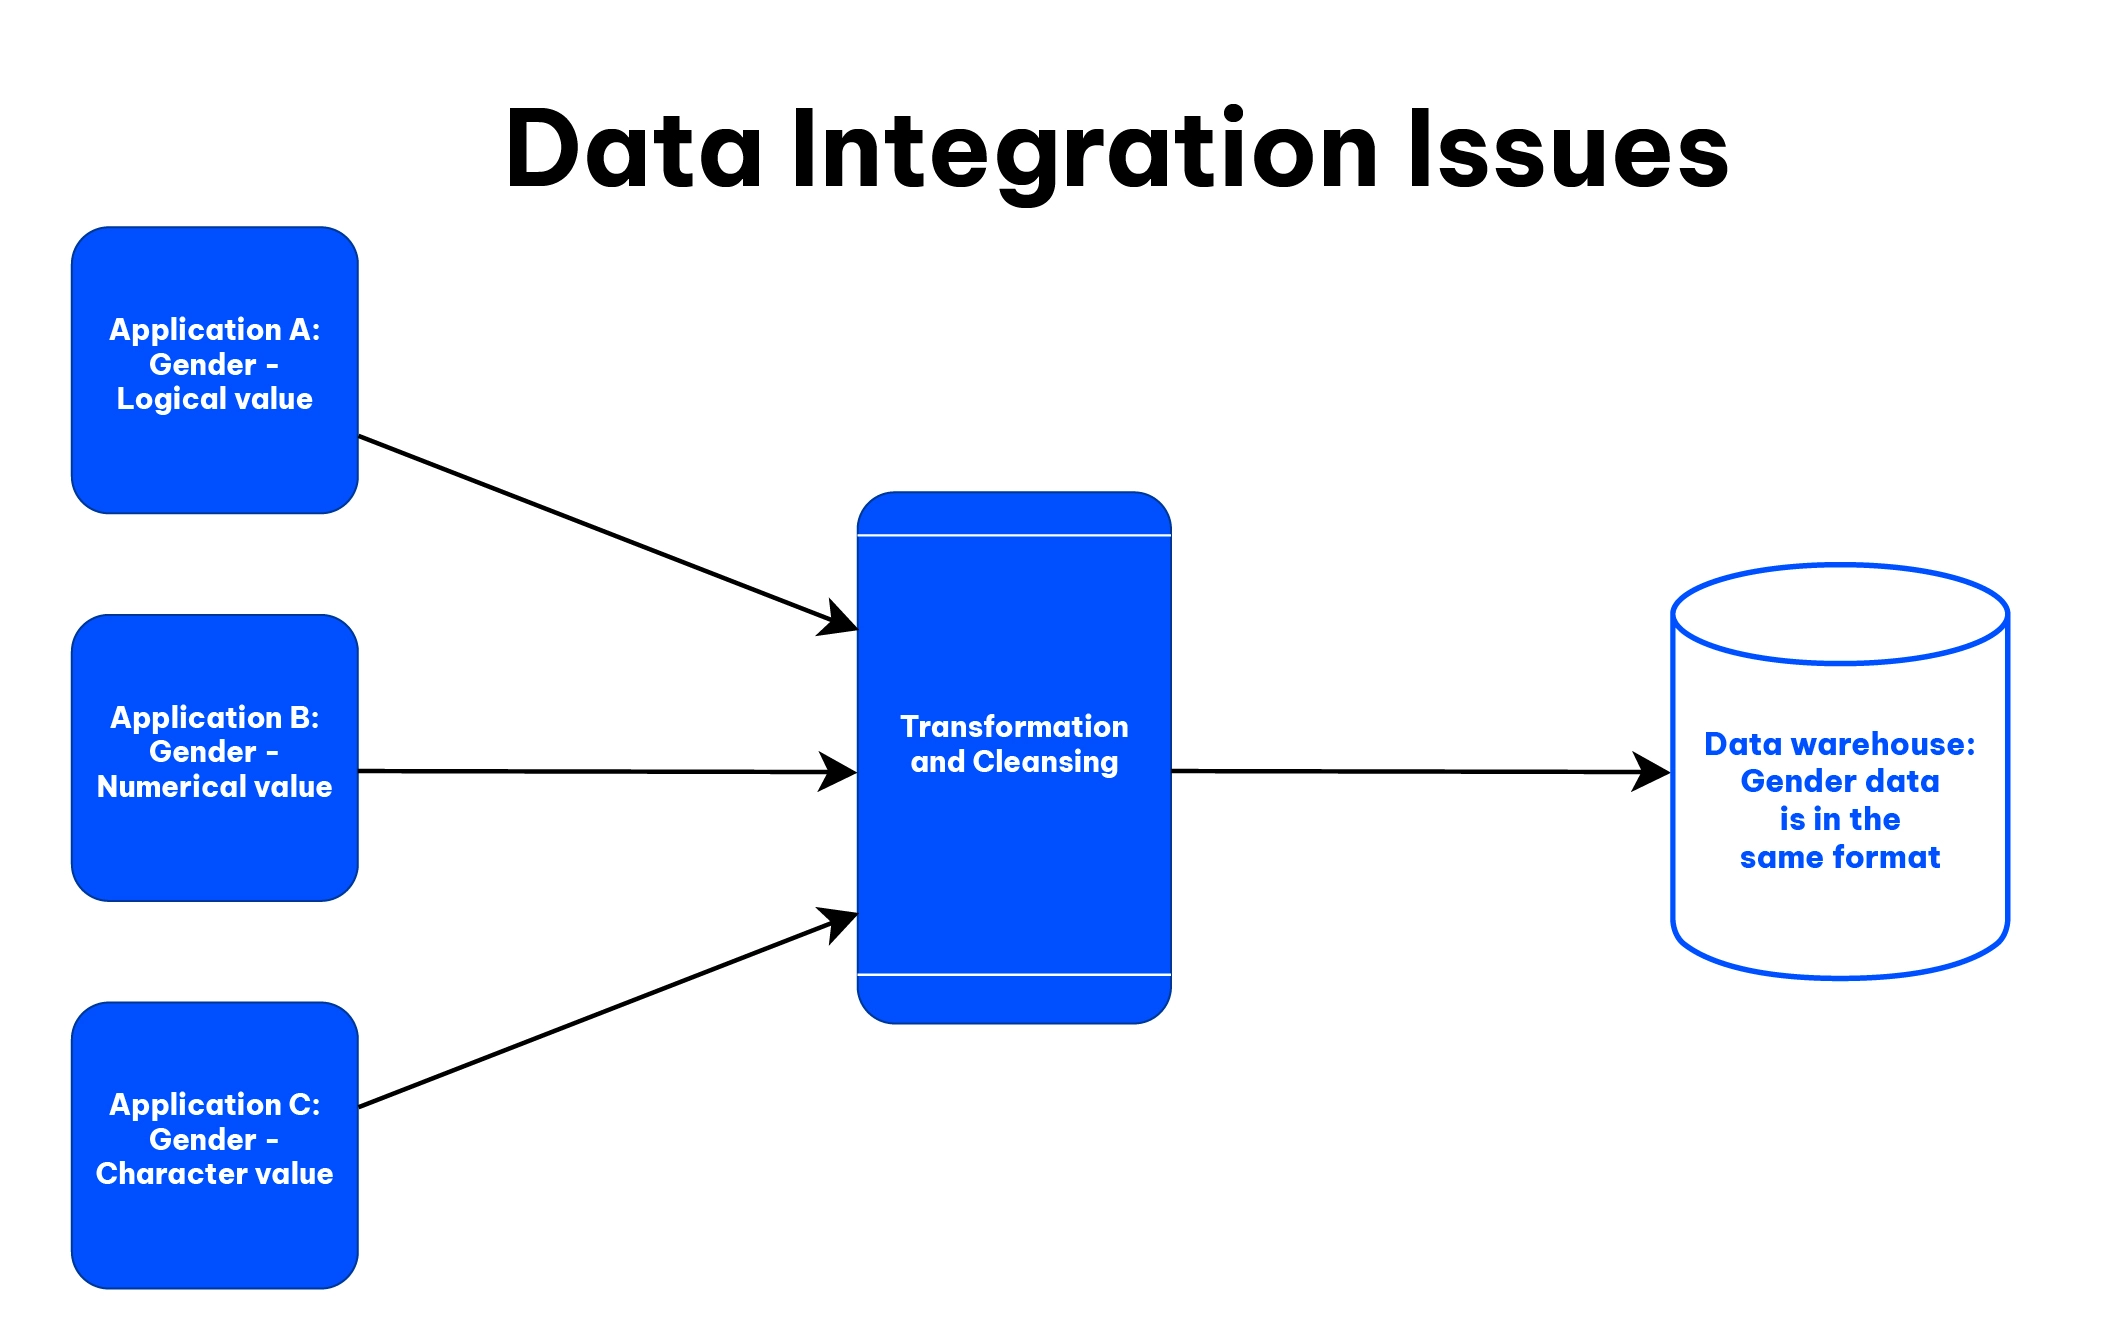
예를 들어 성별, 날짜, 잔액 정보를 담고 있는 A, B, C라는 세 가지 애플리케이션이 있다고 가정해 보겠습니다. 하지만 위 그림과 같이 각 애플리케이션에서는 성별 데이터가 서로 다른 형식으로 저장됩니다.
- 애플리케이션 A: 성별 데이터가 논리값입니다.
- 애플리케이션 B: 성별 데이터가 숫자값입니다.
- 애플리케이션 C: 성별 데이터가 문자값입니다.
처리 및 정제 과정을 거친 후, 세 애플리케이션의 성별 데이터는 데이터 웨어하우스에서 동일한 형식으로 변환됩니다.
시계열성
시계열성은 데이터 웨어하우스가 일정 기간 동안 일관성을 유지한다는 고유한 특성입니다. 즉, 데이터 웨어하우스에는 매일, 매시간 또는 다른 주기에 따라 데이터가 적재되며, 해당 기간 내에는 데이터가 변경되지 않습니다. 이 특성은 일상적인 비즈니스 거래 기록을 저장하고 최신 정보만 유지할 수 있는 운영 시스템과 데이터 웨어하우스(DW)를 구별합니다.
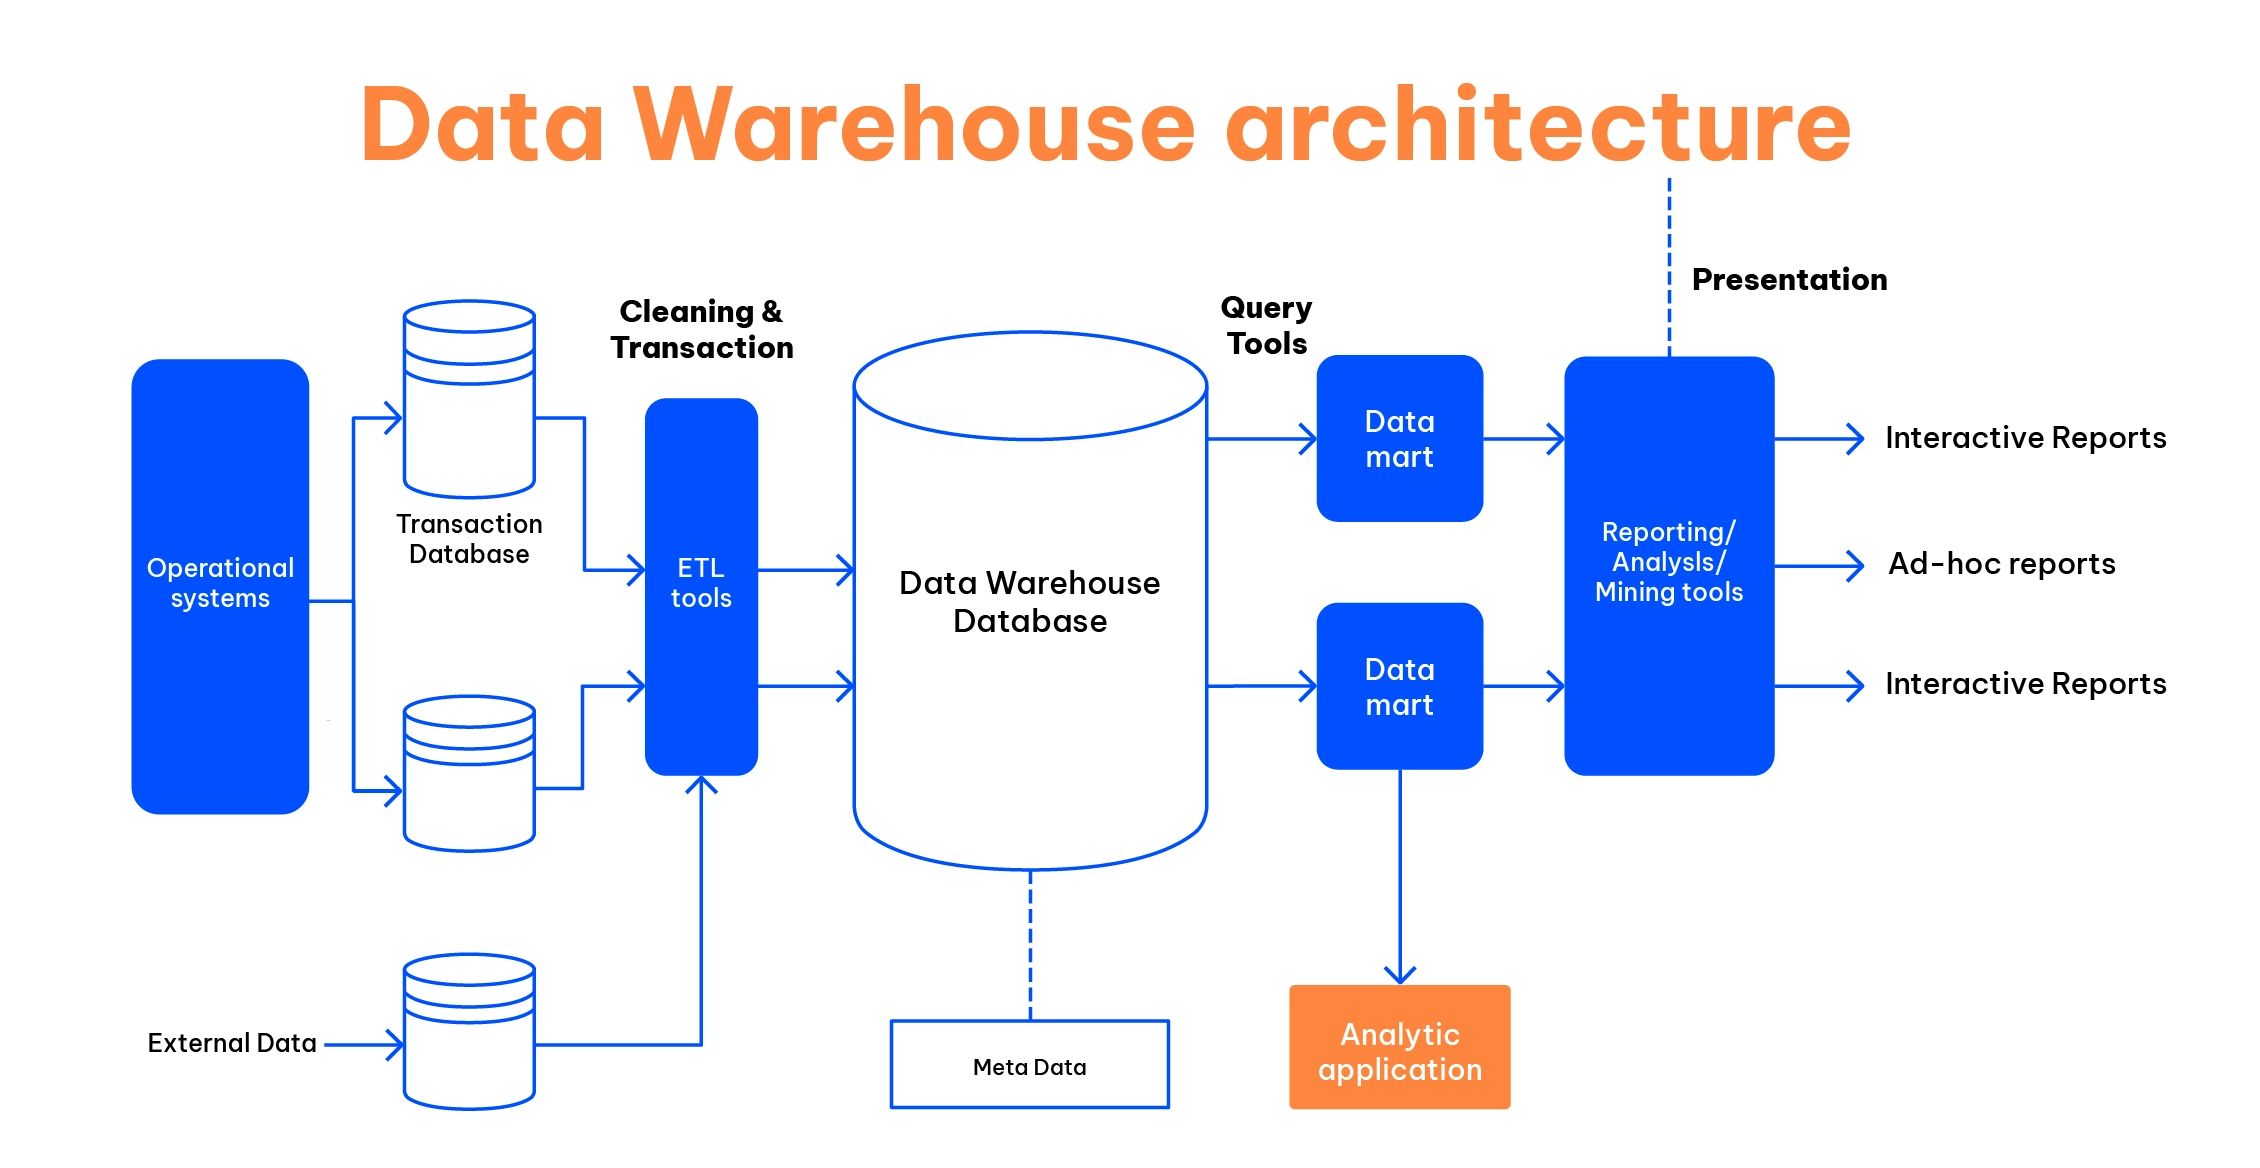
그림 1에서 볼 수 있듯이, 운영 시스템은 데이터가 데이터 웨어하우스에 적재되기 전의 원천 데이터 출처로 간주됩니다. 데이터 웨어하우스의 과거 데이터는 주어진 기간에 걸쳐 조회되고 분석됩니다. 반면 트랜잭션 시스템에서는 오래된 데이터가 이동되거나 삭제됩니다.
예를 들어 한 고객이 귀사의 제품을 구매했다고 가정해 보겠습니다. 이 고객은 호주 멜버른에 살다가 시드니로 이사하여 2008년부터 2013년까지 거주했습니다. 현재는 2014년 7월부터 프랑스 파리에 정착해 살고 있습니다.
기업은 데이터 웨어하우스를 사용하여 고객의 모든 과거 주소를 조회할 수 있지만, 트랜잭션 시스템은 현재 주소만 업데이트합니다.
비휘발성
데이터 웨어하우스에 보관된 데이터는 영구적이므로 새로운 데이터가 입력되어도 지워지거나 삭제되지 않습니다. 데이터는 미리 정해진 시점에 갱신되며 읽기 전용이므로 과거 데이터를 검토하고 분석하는 데 유용합니다.
트랜잭션 처리, 복구 및 동시성 제어 기법은 필요하지 않습니다. 데이터 웨어하우스 환경에서는 운영 애플리케이션에서 수행하는 삭제, 업데이트, 삽입 등의 기능이 제외됩니다. 대신 다음 두 가지 유형의 데이터 작업이 있습니다.
- 데이터 적재
- 데이터 접근
데이터 웨어하우스 아키텍처
현대의 데이터 웨어하우스에는 데이터를 적절하게 저장, 정제 및 구성하기 위한 설계와 구성 요소로서 “데이터 웨어하우스 아키텍처”가 필요합니다. 데이터 웨어하우스 아키텍처의 주요 목적은 맞춤형 쿼리, 비즈니스 분석 및 의사결정을 지원하기 위해 다양한 데이터 소스의 기업 정보를 통합하는 데 가장 효과적인 접근 방식을 결정하는 것입니다.
아래 데이터 웨어하우스 모델에 따르면 이 프로세스에는 다음과 같은 다섯 가지 주요 구성 요소가 있습니다.
- 데이터 웨어하우스 접근 도구(ETL 도구)
- 중앙 데이터베이스(데이터 웨어하우스 데이터베이스)
- 메타데이터
- 쿼리 도구
- 데이터 웨어하우스 버스
그러나 구성 요소는 기업의 요구 사항과 여건에 따라 달라질 수 있습니다.
데이터 웨어하우스 접근 도구(ETL 도구)
ETL 도구는 원본 소스에서 데이터를 추출한 다음 데이터 웨어하우스에 입력하기 전에 표준 형식으로 변환합니다.
이러한 ETL 도구가 수행하는 작업은 다음과 같습니다.
- 운영 데이터베이스의 데이터를 데이터 웨어하우스에 적재하기 전에 관련 없는 데이터 제거
- 요약값 및 추출된 데이터에 대한 계산 수행
- 누락된 데이터에 기본값 설정
- 여러 원본 소스에서 가져온 중복 데이터 제거
- 서로 다른 소스에서 가져온 데이터의 명칭과 정의를 식별하고 공통된 명칭과 정의로 대체합니다.
중앙 데이터베이스
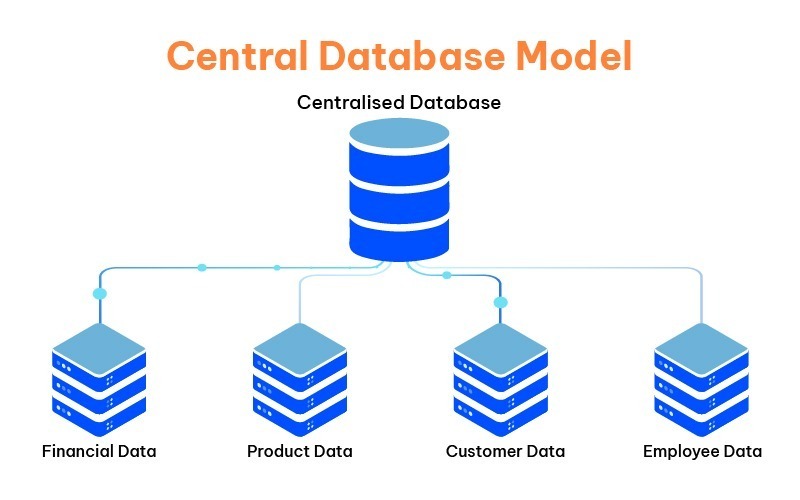
중앙 데이터베이스는 조직의 모든 데이터를 보관하고 분석 및 보고에 사용할 수 있도록 하는 데이터베이스입니다. 핵심은 기업이 데이터 웨어하우스에 정보를 저장하는 데 적합한 데이터베이스 유형을 결정해야 한다는 점입니다.
최근 많은 기업이 견고한 기반을 구축하기 위해 관계형 데이터베이스를 중앙 데이터베이스로 선택하고 있습니다. 오늘날 관계형 기술의 발전에 힘입어 관계형 데이터베이스는 비즈니스 인텔리전스, 데이터 통합 및 데이터 웨어하우징에 점점 더 많이 활용되고 있습니다.
비즈니스 인텔리전스에서 관계형 데이터베이스를 지원하기 위해 다양한 대체 기술이 기술 아키텍처의 여러 부분에서 관계형 데이터베이스를 대체하고 있습니다. 널리 사용되는 기술은 다음과 같습니다:
- OLAP 데이터베이스
- 대규모 병렬 처리(MPP) 데이터베이스
- 데이터 가상화
- 데이터베이스 내 분석
- 인메모리 분석
- 클라우드 기반 BI, DW 또는 데이터 통합
- NoSQL 데이터베이스
메타데이터
메타데이터는 기업에서 생성, 변환, 저장, 접근 및 활용되는 “데이터에 관한 데이터”입니다. 메타데이터는 데이터 웨어하우스에서 데이터가 수정되고 처리되는 방식을 결정합니다. 또한 데이터의 출처, 용도, 값 및 특성을 명확히 합니다.
메타데이터를 효과적으로 관리하려면 데이터가 무엇을 나타내는지, 어디에서 추출되었는지, 어떻게 변환되었는지 등을 이해하는 것이 중요합니다. 이를 통해 비즈니스 분석에 필요한 일관되고 완전하며 검증된, 정제된 최신 데이터를 제공할 수 있습니다.
메타데이터가 원시 데이터를 가치 있는 지식으로 전환하는 예:
원시 데이터: 2501 TK019 09.08.22
- 모델 번호: 2501
- 영업 담당자 ID: TK019
- 날짜: 09/08/2022
메타데이터에는 기술 메타데이터와 비즈니스 메타데이터의 두 가지 유형이 있습니다.
기술 데이터: 소프트웨어 도구로 처리되는 데이터로, 주로 데이터 웨어하우스 설계자와 관리자가 사용합니다. 예를 들면 다음과 같습니다:
- ETL 도구는 필드, 소스와 대상 간의 매핑, 변환 및 워크플로를 지정합니다.
- 데이터베이스는 열(형식, 크기 등), 테이블 및 인덱스를 면밀히 검토합니다.
- BI 도구는 필드를 해석하고 이를 보고서로 작성합니다.
비즈니스 데이터: 최종 사용자가 데이터 웨어하우스에 저장된 특정 데이터 세트를 더 쉽게 이해할 수 있도록 하는 데이터입니다. 예를 들어 주간 매출, 재고 회전율 또는 예산 차이에 대한 보고에 필요한 비즈니스 맥락이 비즈니스 데이터에 해당합니다.
쿼리 도구
쿼리 도구를 통해 조직은 데이터 웨어하우스 시스템과 상호 작용할 수 있습니다
쿼리 도구에는 네 가지 유형이 있습니다:
- 쿼리 및 보고 도구
- 애플리케이션 개발 도구
- 데이터 마이닝 도구
- OLAP 도구
데이터 웨어하우스 버스
데이터 웨어하우스 버스는 데이터 웨어하우스 내의 데이터 흐름을 결정하며, 이 흐름은 유입, 유출, 상향 흐름, 하향 흐름 및 메타 흐름으로 구성됩니다. 데이터 버스를 구축할 때는 데이터 마트 간에 공유되는 차원과 팩트를 철저히 고려해야 합니다.
데이터 마트
데이터 마트는 영업, 마케팅, 재무 또는 인사와 같은 특정 비즈니스 영역에 초점을 맞춘 데이터 웨어하우스의 하위 집합입니다. 일반적으로 하나의 부서에서 관리하며, 조직 내 특정 팀이 사용합니다. 데이터 웨어하우스와 달리 데이터 마트는 규모가 더 작고 유연하며, 더 적은 수의 입력 소스에서 데이터를 가져옵니다.
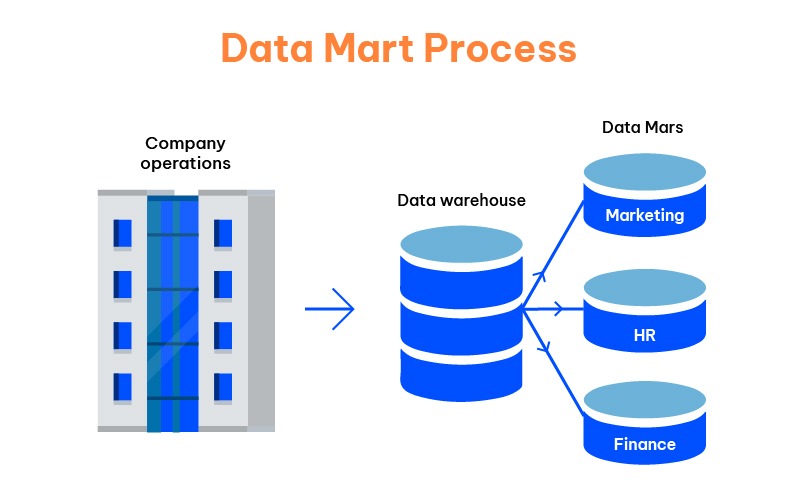
데이터 마트를 구현하는 데에는 다섯 가지 기본 단계가 있습니다.
1단계: 설계
- 기술 및 비즈니스 요구사항을 수집하고 데이터 소스를 파악합니다.
- 적합한 데이터 하위 집합을 선택합니다.
- 데이터 마트의 논리적 및 물리적 구조를 수립합니다.
2단계: 구축
이전 단계에서 수립한 실제 데이터베이스를 배포합니다.
예를 들어 테이블, 인덱스, 뷰 등 데이터베이스 스키마에 사용되는 객체가 포함됩니다.
3단계: 데이터 적재
- 대상 데이터로의 매핑 작성
- 데이터 소스에서 데이터 추출
- 데이터 정제 및 변환
- 데이터 마트에 데이터 적재
- 메타데이터 구축 및 보관
4단계: 접근
접근 단계에서는 다음 작업을 수행해야 합니다.
- 데이터베이스 구조와 객체 이름을 비즈니스 용어로 변환하는 메타 계층을 도입합니다 -> 비기술 사용자가 데이터 마트에서 쉽게 작업할 수 있도록 지원합니다.
- 데이터베이스 구조를 구축하고 발전시킵니다.
- 필요한 경우 API와 인터페이스를 구축합니다.
5단계: 관리
데이터 마트 구현 프로세스는 이 단계로 마무리됩니다. 이 단계에는 다음과 같은 관리 업무가 포함됩니다.
- 지속적인 사용자 접근 관리
- 시스템 성능 최적화 및 조정
- 데이터 마트에 새로운 데이터를 순차적으로 적재하고 관리
- 복구 방법을 마련하고 시스템 장애 발생 시 시스템 가용성을 보장합니다.
데이터 웨어하우스 보고 계층
최종 사용자는 데이터 웨어하우스의 보고 계층을 통해 BI 인터페이스 또는 데이터베이스 아키텍처에 접근할 수 있습니다. 데이터 웨어하우스의 보고 계층은 데이터 시각화, 보고서 작성 및 추출을 위한 대시보드 역할을 합니다.
데이터 웨어하우스는 통일된 형식의 데이터만 가져옵니다. 따라서 여러 소스의 원시 데이터를 적절한 데이터 형식으로 변환하려면 ETL 도구와 같은 최적의 도구를 사용하는 것이 필수적입니다. ETL 도구는 높은 데이터 품질을 보장하면서 방대한 양의 데이터를 추출하고 변환하여 데이터 웨어하우스에 적재하는 속도와 효율성을 높일 수 있습니다. Make your digital transformation seamless and future-ready Accelerate your business growth with zero-disruption modernization services. Maximize the value of your current infrastructure, streamline processes, and cut expenses.
데이터 웨어하우스의 ETL(추출, 변환 및 적재)
그렇다면 데이터 웨어하우스에서 ETL 프로세스는 어떤 역할을 할까요? 프로세스를 간소화하고 효율성을 높이기 위해 어떻게 활용될까요?
정의
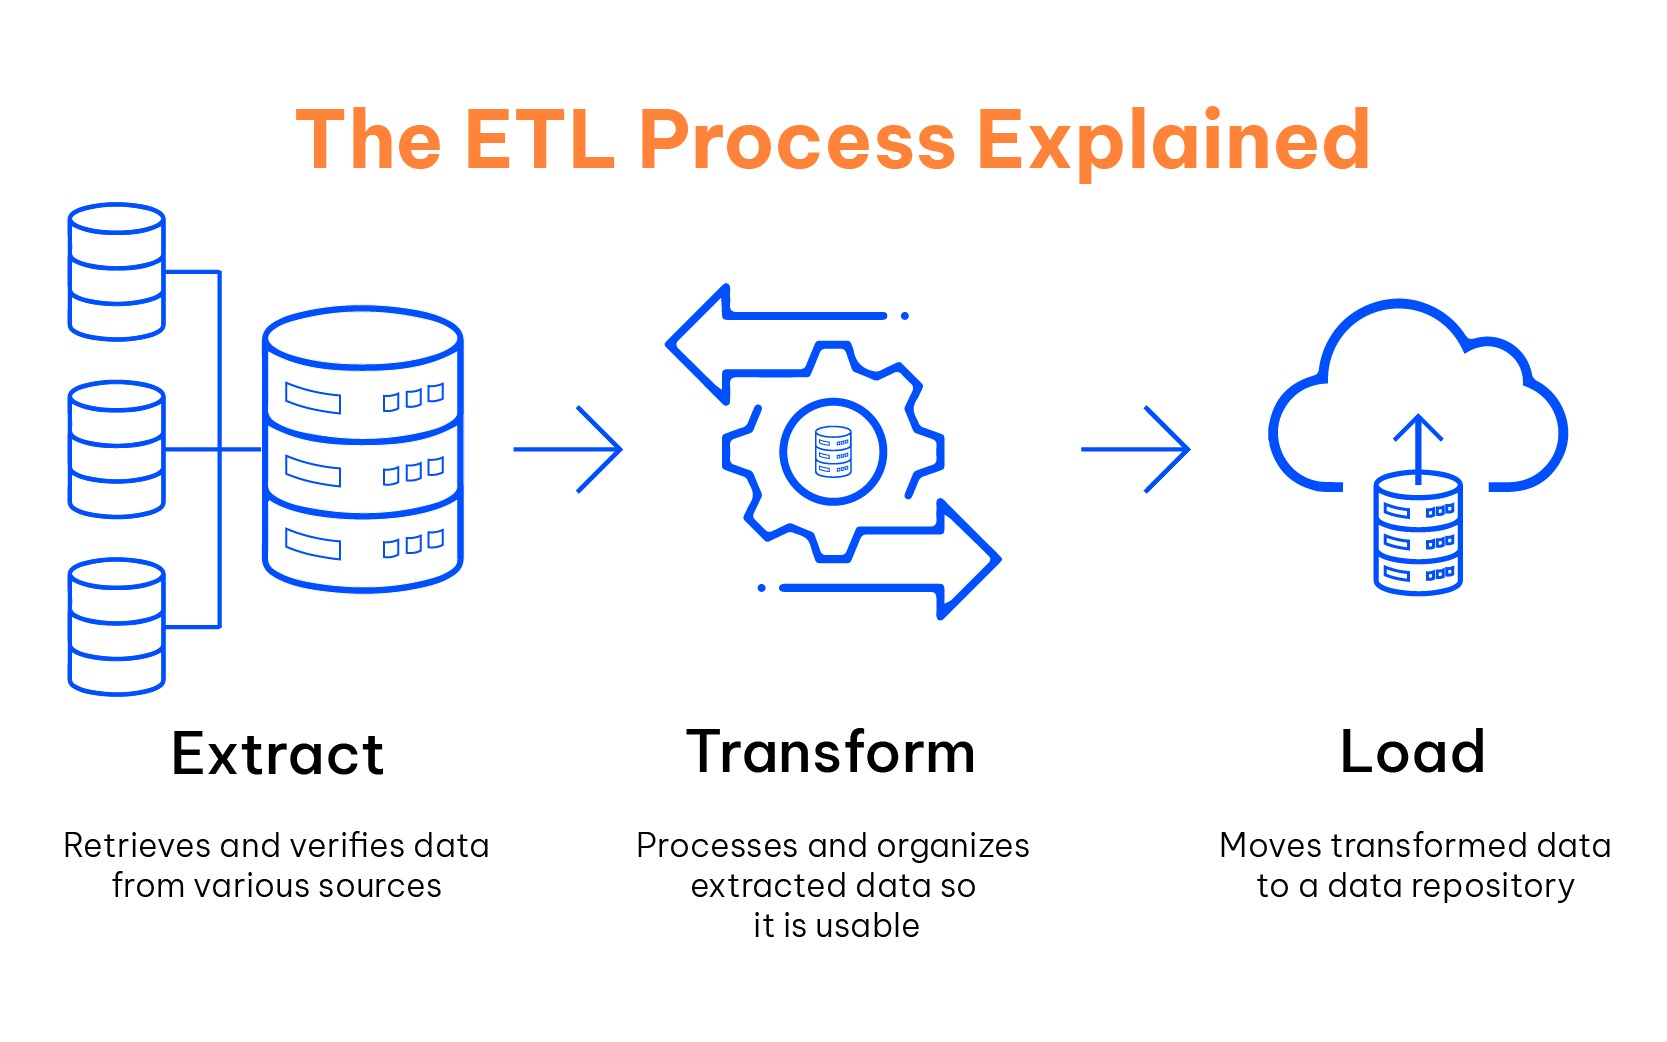
ETL은 Extract, Transform, Load의 약자로 추출, 변환, 적재를 뜻하며, 향후 작업을 위해 서로 다른 소스의 데이터를 하나의 통합된 뷰로 결합하는 세 단계입니다.
Google Cloud에 따르면 ETL은 “기업이 정형 및 비정형 데이터를 포함하여 전 세계 어디에서든 여러 팀이 관리하는 모든 데이터를 가져와 비즈니스 목적에 유용하게 활용할 수 있는 상태로 만드는 전체 과정“입니다.
쉽게 생각하면 ETL을 의류 매장으로, 상품을 데이터로 상상할 수 있습니다. 첫 번째 단계는 여러 옷걸이에서 옷을 가져오는 것입니다. 그다음에는 고객의 요구에 따라 꽃무늬 또는 물방울무늬 포장지로 옷을 포장해야 합니다. 마지막으로 포장한 옷을 고객의 쇼핑백에 넣는 것이 여러분의 역할입니다.
ETL은 어떻게 작동할까요?
물론 ETL은 데이터와 내부 처리 과정에 대한 더 깊은 이해가 필요하므로 의류 매장처럼 단순하게 작동하지는 않습니다. 아래에서 설명하듯이 ETL은 데이터를 통합하고 데이터 웨어하우스에 적재하는 역할을 합니다. ETL은 다음 세 단계로 이루어집니다.
추출
ETL 프로세스의 첫 번째 단계는 데이터 추출입니다. 이 단계의 주요 기능은 다음과 같은 다양한 소스에서 데이터를 가져오는 것입니다.
- 레거시 데이터베이스 및 스토리지.
- 고객 관계 관리 시스템(CRM).
- 전사적 자원 관리 시스템.
- 사물인터넷(IoT)의 센서 데이터.
- 영업 및 마케팅 애플리케이션.
- 고객 거래 데이터.
- 소셜 미디어 및 기타 온라인 소스.
데이터 소스는 정형 데이터(바로 추출할 수 있는 데이터), 비정형 데이터(추출 전에 공백이나 이모티콘 제거 등의 변환이 필요한 데이터) 등 다양한 형식일 수 있으며, 기존 데이터베이스, CRM 시스템, 클라우드, 데이터 웨어하우스에서 가져올 수도 있습니다.
데이터를 추출하는 세 가지 방식:
- 알림 기반 데이터 추출: 데이터를 가져오는 가장 간단한 방법 중 하나입니다. 구체적으로 일부 데이터 소스는 데이터가 변경될 때마다 ETL 시스템에 알림을 보냅니다. ETL의 추출 단계에서는 새로운 데이터만 갱신하면 됩니다.
- 전체 추출: 일부 소스는 데이터의 변경 사항을 감지할 수 있으므로 ETL은 소스에서 전체 데이터를 추출해야 합니다. 이 추출 방식에서는 마지막으로 추출한 데이터의 사본을 보관해야 하며, 이를 통해 새 사본과 비교할 수 있습니다. 데이터 전송량이 많기 때문에 전체 추출 방식은 작은 테이블에 사용하는 것이 좋습니다.
- 부분 추출: 알림 기반 데이터 추출과 달리 일부 소스는 데이터 변경 알림을 보내지 않지만 어떤 데이터가 변경되었는지 기록을 보유합니다. ETL 시스템은 정기적으로 소스를 확인하여 변경 사항이 있는지 파악하고 변경된 데이터를 점진적으로 추출합니다. 이 추출 단계의 단점은 ETL 시스템이 소스 데이터에서 삭제된 레코드를 식별할 수 없다는 점입니다.
변환
데이터는 원래 형식 그대로 데이터 웨어하우스에 전달할 수 없는 경우가 많습니다. 따라서 원시 데이터를 처리하기 위한 몇 가지 하위 단계가 있습니다.
- 정제: 관련 없는 데이터를 제거하고 일관되지 않거나 누락된 값을 수정합니다.
- 표준화: 서로 다른 형식의 데이터를 공통 형식으로 변환합니다.
- 중복 제거: 불필요하게 중복되거나 반복되는 데이터를 제거합니다.
- 검증: 데이터의 정확성을 검증합니다. 이 단계에서 ETL 시스템은 비정상적인 데이터를 찾아 표시합니다.
- 정렬: 유형에 따라 데이터를 정리합니다.
데이터 변환에 특정 규칙이 필요하지 않은 경우 이를 직접 이동 또는 패스스루 데이터라고 합니다. 그러나 경우에 따라 데이터 품질과 가용성을 보장하기 위해 요구 사항에 따른 여러 조건을 적용해야 합니다.
적재
ETL 프로세스의 마지막 단계는 적재 단계입니다. 이 단계에서는 변환된 데이터를 새로운 대상 위치인 데이터 웨어하우스에 적재합니다. 대상 위치의 데이터 형식은 텍스트 파일, Excel 파일, JSON 파일, XML 파일 또는 데이터베이스일 수 있습니다.
변환된 데이터를 적재하는 방법에는 두 가지가 있습니다:
- 전체 적재: 전체 적재는 변환된 모든 데이터를 단일 배치로 데이터 웨어하우스나 저장소에 새로운 고유 레코드로 적재합니다. 이 방법은 증분 적재보다 간단하지만 시간이 더 오래 걸립니다.
- 증분 적재: 이 적재 방식은 새로 유입되는 데이터와 기존 데이터를 구분합니다. ETL 시스템은 고유한 데이터가 발견된 경우에만 새 레코드를 추가합니다. 증분 적재는 관리하기가 더 쉽지만 시스템 장애가 발생하면 데이터 불일치가 생길 수 있습니다. 적절한 적재 전략을 결정하려면 개별 요구 사항과 데이터 대상의 특성(속도, 용량, 데이터 인터페이스)을 비롯한 여러 요소를 고려해야 합니다.
일반적인 요구 사항은 다음과 같습니다:
- 데이터 위에 비즈니스 인텔리전스와 분석을 위한 계층을 구축합니다.
- 데이터를 검색 가능한 데이터베이스로 활용합니다.
- 머신러닝 알고리즘을 위한 학습 모델을 만듭니다.
- 데이터를 기반으로 알림 시스템을 구축합니다.
ETL 도구의 다양한 유형
ETL 도구는 원시 데이터 추출, 표준 형식으로의 변환, 데이터 웨어하우스로의 적재에 이르는 ETL 프로세스를 지원하는 소프트웨어 애플리케이션입니다. 이러한 도구는 데이터 관리 시스템의 운영을 원활하게 하고 데이터 품질을 보장하는 데 도움이 됩니다.
Hub Spot에 따르면 조직이나 공급업체가 제공하는 인프라와 지원을 기준으로 ETL 도구를 네 가지 유형으로 구분할 수 있습니다:
Hub Spot에 따르면 조직이나 공급업체가 제공하는 인프라와 지원을 기준으로 ETL 도구를 네 가지 유형으로 구분할 수 있습니다.
기업용 소프트웨어 ETL 도구
상업 기업은 기업용 소프트웨어 ETL 제품을 개발하고 판매합니다. 이러한 기업들은 ETL 도구의 도입을 가장 먼저 주도했기 때문에 이들이 제공하는 솔루션은 업계 전반에서 가장 신뢰할 수 있고 성숙한 편입니다. 이러한 도구는 ETL 파이프라인을 설계하고 실행하기 위한 그래픽 사용자 인터페이스(GUI)를 제공합니다. 또한 관계형 및 JSON, XML 등의 비관계형 데이터베이스, 이벤트 스트리밍 소스 등을 지원합니다.
기업용 소프트웨어 ETL 도구의 예는 다음과 같습니다:
- Informatica PowerCenter.
- IBM InfoSphere DataStage.
- Oracle Data Integrator (ODI).
- Microsoft SQL Server Integration Services (SSIS).
- Ab Initio.
- SAP Data Services.
- SAS Data Manager.
오픈소스 ETL 도구
오픈소스 운동의 성장은 오픈소스 ETL 도구의 기능과 속도를 높이고 발전을 촉진합니다. 많은 오픈소스 ETL 도구는 무료로 제공되며 GUI를 통해 실용적으로 사용할 수 있습니다. 이러한 도구는 데이터 공유 프로세스를 설계하고 정보 흐름을 관리하는 데 사용됩니다.
이러한 ETL 도구에는 장점과 단점이 모두 있습니다. 오픈소스 솔루션의 장점은 소스 코드에 접근할 수 있어 조직이 도구의 인프라를 살펴보고 기능을 확장할 수 있다는 점입니다. 그러나 일반적으로 상업 기업의 지원을 받지 못하므로 일관성이 부족하다는 단점이 있습니다.
오픈소스 ETL 도구의 예는 다음과 같습니다:
- Talend Open Studio.
- Pentaho Data Integration (PDI).
- Hadoop.
클라우드 기반 ETL 도구
Amazon AWS, Google Cloud Platform, Microsoft Azure 등 많은 클라우드 서비스 제공업체(CSP)는 자체 인프라에서 ETL 도구를 개발해 왔습니다. 이는 클라우드 컴퓨팅과 서비스형 통합 플랫폼의 확산으로 등장했습니다.
오픈 소스 ETL 도구와 마찬가지로, 클라우드 기반 ETL 도구에도 장단점이 있습니다. 장점으로는 잠재력, 효율성, 탄력성을 들 수 있습니다. 컴퓨팅 리소스는 현재의 데이터 처리 요구에 맞춰 확장됩니다. 또한 기업이 동일한 클라우드 서비스 제공업체에 데이터를 보관하면 파이프라인을 더욱 최적화할 수 있습니다.
반면 클라우드 기반 ETL 도구의 단점은 독점성이 매우 높고 특정 클라우드 공급업체의 플랫폼에서만 사용할 수 있다는 점입니다. 조직은 서로 다른 클라우드 스토리지의 데이터를 활용해 자체 데이터 센터로 옮길 수 없습니다.
클라우드 기반 ETL 도구의 예시는 다음과 같습니다.
- AWS EMR.
- AWS Glue.
- Azure Data Factory.
- Google Cloud Dataflow.
맞춤형 ETL 도구
많은 기업이 범용 프로그래밍 언어를 사용해 자체 ETL 솔루션을 개발합니다. 이 방식은 유연성이 매우 높으며 조직의 요구 사항과 업무 흐름에 맞는 솔루션을 만들 수 있습니다. 반면 이러한 도구의 단점은 구축과 운영에 가장 많은 노력과 비용이 든다는 점입니다.
자체 ETL 도구 구축에 널리 사용되는 프로그래밍 언어:
- SQL.
- Python.
- Java.
이 네 가지 유형의 ETL 도구에 대해 더 자세히 알아보려면 여기에서 심층 분석을 읽어보세요!
결론
데이터 웨어하우스는 데이터를 통일된 형식으로 저장하는 곳입니다. 하지만 여러 소스에서 데이터를 추출하고 변환한 후 최종적으로 데이터 웨어하우스에 적재하려면 ETL 프로세스가 필요합니다. 빅데이터의 발전과 함께 모든 산업에서 ETL의 중요성이 더욱 커졌습니다.
비즈니스 이니셔티브와 필수 과제의 높은 요구 수준에 따라 ETL 환경은 점차 크게 변화해 왔습니다. Deloitte에 따르면 미래의 ETL은 도구보다 데이터 스트림에 더 집중하게 될 것입니다. 조직은 실시간 지연 시간, 스키마의 변화, 소스 중심 접근 방식, 지속적인 통합을 고려하는 것이 좋습니다. ETL은 데이터 통합, 거버넌스, 품질, 보안을 위한 궁극적인 솔루션으로 자리 잡은 만큼, 앞으로 더욱 폭넓게 활용될 전망입니다. Imagine What You Could Achieve with AI Streamlining Your Operations Transform your operations with precise, AI-driven workflows. From reducing errors to improving speed, achieve operational excellence and drive sustainable growth.
데이터의 활용 가치를 더욱 높이는 방법
데이터 파이프라인의 모든 단계에서 쌓은 실무 경험을 바탕으로, GEM의 포괄적인 데이터 서비스는 데이터를 원활하게 통합하고 중요한 비즈니스 의사결정에 즉시 활용할 수 있도록 지원합니다.
GEM은 이 중요한 자산에서 얻는 가치를 높일 수 있도록 돕겠습니다. 지금 상담해 보세요!


